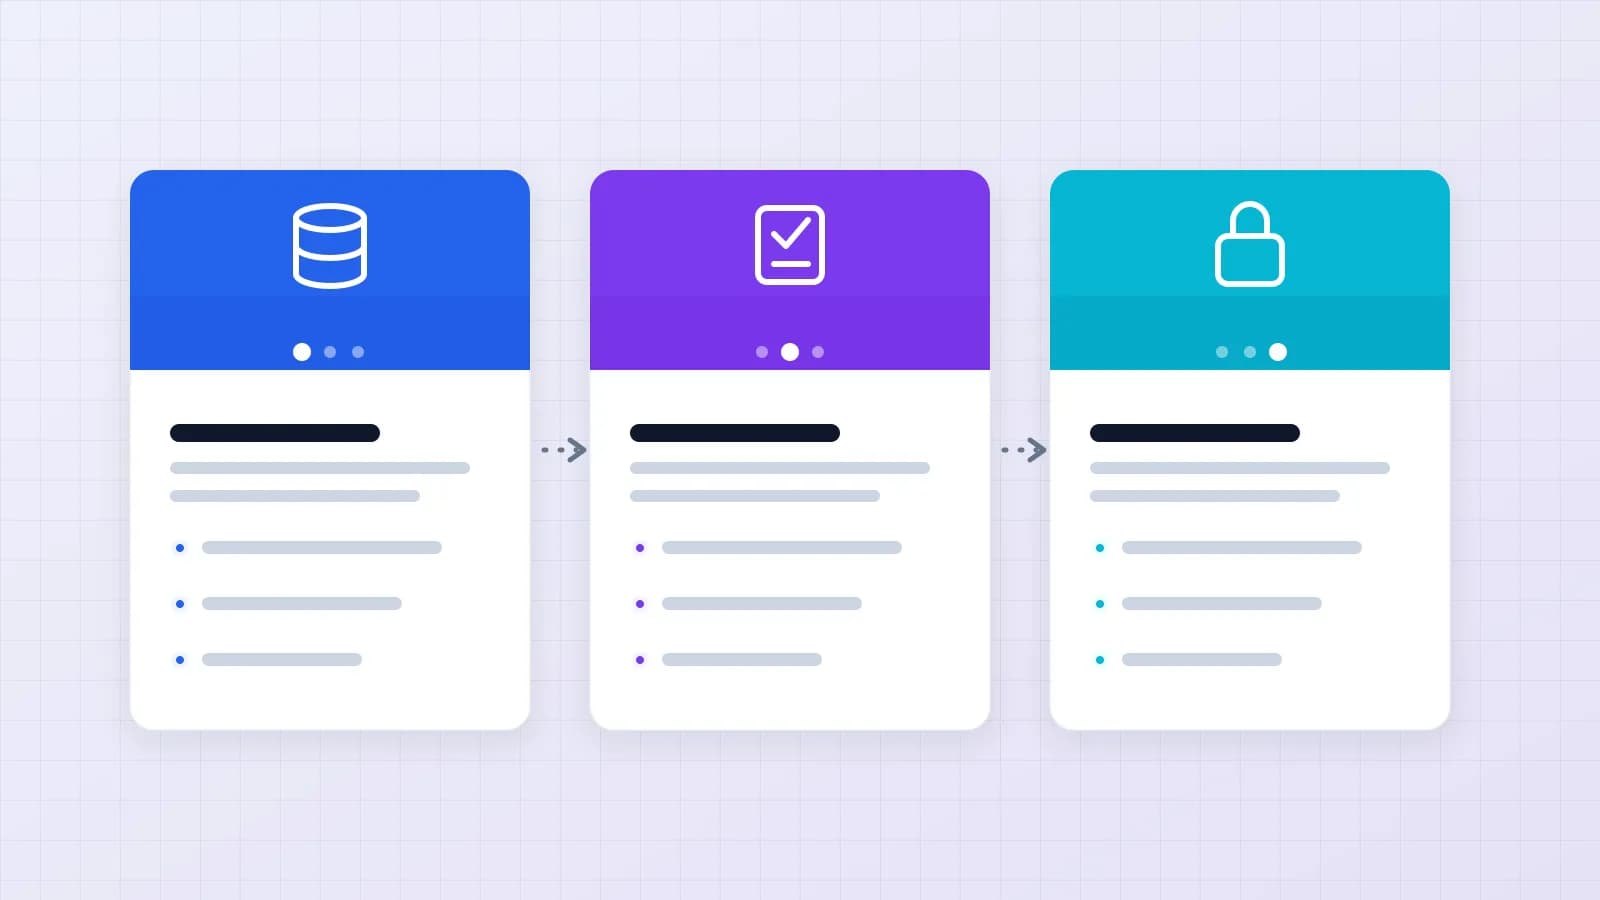
做一个能回答问题的大模型演示,现在只需要一个下午;让它在企业里稳定运行一年,却常常要几个月。中间的差距不在模型,而在三件基础工作上。
第一关:数据
模型回答质量的上限由喂给它的资料决定。我们在项目里遇到最多的问题不是"资料不够",而是资料混乱:同一份制度有三个版本、扫描件没有文字层、表格被拆成碎片、关键信息藏在图片里。
可操作的做法是先做一次"资料盘点":确定哪些文档是权威版本、由谁维护、多久更新一次;扫描件先做 OCR;表格和图表单独处理而不是当作普通段落。这一步通常占整个项目三分之一的时间,但省不掉。
第二关:评测
没有评测集,就没有优化方向,也没法回答"上线后效果会不会变差"。评测集不需要很大:一百条来自真实用户的问题,配上业务负责人认可的答案,就足够发现大部分问题。
每次调整检索策略、提示词或模型版本,都用同一套评测集跑一遍,看准确率和引用命中率的变化。这比"感觉好像好了一点"可靠得多。
第三关:权限
企业资料天然有访问边界:财务数据不能给销售看,客户合同不能跨部门查。很多演示之所以"效果惊人",是因为把所有资料都放进了同一个池子。
进入生产环境时,检索层必须继承原有系统的权限:用户只能检索到自己有权限的文档片段,模型也只看到这些片段。这件事要在架构阶段就设计好,事后补很难。
顺序很重要
我们建议的顺序是先用两周做个小范围原型,确认这个场景值得投入;再花时间做资料盘点和评测集;最后才是生产化和权限集成。跳过中间两步直接上线,用户试几次发现答得不准就不用了,过几周还是得返工。